株式会社 Polyscape 代表取締役の島田です。
AI駆動開発に関する考え方が日々進化する中で、AI Engineer World’s Fair などをきっかけに、2026年夏ごろから「ソフトウェアファクトリー」という考え方が米国を中心にでてきました。
この記事では、最新のソフトウェアファクトリーの文献やUberが公開したソフトウェアファクトリーの事例を手掛かりに、コードレビューだけでなく、デザインやUXまで含めた検品ハーネスをどのように考えるべきかを整理します。
ソフトウェアファクトリーとは何か
2026年のAI Engineer World’s Fairを振り返ったLatent Spaceの記事は、AIエンジニアリングが「エージェントを使って作る」段階から、エージェントが働くシステムそのものを作る段階へ移ったと整理しています。個々のモデルやプロンプトではなく、ワークフロー、コンテキスト、権限、評価、永続状態、継続改善を管理するハーネスが、モデルと同じくらい重要になったという指摘です。[1]
その延長線上で語られているのが、ソフトウェアファクトリーです。同記事では、CursorのPauline Brunet氏の説明として、ソフトウェアファクトリーを「長時間稼働するエージェントが、プロセス全体を通じて人を支援するもの」と紹介しています。ここでいう「ファクトリー」は、単体のコーディングエージェントや、コードを高速に吐き出すツールの名前ではありません。複数のエージェント、スキル、検査、承認、修正、リリースをつなぎ、ソフトウェアを継続的に作って届ける開発体制そのものを指します。
個人的には、ソフトウェアファクトリーは、「実装だけではなく、検品やデリバリ、さらには保守といった、開発のライフサイクルの最初から最後まで一気通貫して工場のように行うことができるAI駆動開発パイプライン」と理解するのがわかりやすいと思っています。
Warp CEOのZach Lloyd氏は、AI Engineer World’s Fairのセッション「Self-Improving software factories 」で、「ソフトウェアエンジニアリングは工場を設計する仕事になる」という主張をしました。つまり、エンジニアの仕事が「ソフトウェアを作る仕事」から「ソフトウェアを作る開発体制を作る仕事」に変わるということです。
もう一つ重要なのが、自動化の範囲は組織ごとに設計するという点です。同氏の説明では、対象リポジトリ、ソフトウェアライフサイクルのどこを自動化するか、どこで人をループへ戻すかを選びます。[1] 低リスクな修正は自動で進め、認証、課金、個人情報、基幹データに関わる変更では人が判断する、といった境界もファクトリーの設計に含まれます。
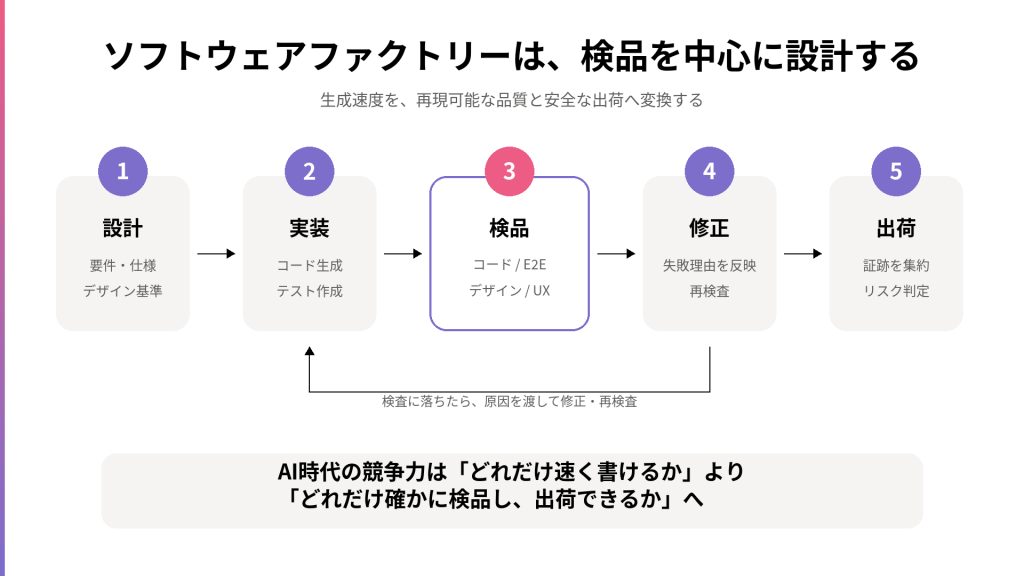
つまり、ソフトウェアファクトリーは「AIが勝手にコードを書く工場」ではありません。要件やデザインを入力として、実装、検証、修正、出荷を長時間稼働するエージェント群が進め、人は目的・品質基準・自動化の境界を設計する仕組みです。工場にたとえるなら、AIモデルは工作機械の一つにすぎません。生産ライン、検査装置、品質基準、停止装置、出荷判定まで揃って、初めてファクトリーになります。
ソフトウェアファクトリーは「コード生成機」ではない
工場という言葉からは、同じ製品を高速に量産するラインを連想します。しかし、ソフトウェア開発では、毎回異なる要件や制約のもとで成果物を作ります。そのため、単純に生成量を増やしても、品質が安定するとは限りません。
Uberは2026年8月に公開した記事「Running a Software Factory Efficiently at Uber Scale」で、同社のプルリクエストの70%以上がローカルまたはクラウドのエージェントに起因し、ソフトウェア開発ライフサイクル全体で3,600以上のエージェントスキルが作られ、1日3万回以上実行されていると説明しています。[2]
注目すべきなのは、エージェントが担当する範囲です。コード生成だけではありません。コードレビュー、失敗したCIの自己修復、視覚検証を含むE2Eのプルリクエスト、不具合の切り分け、保守作業まで、開発ライフサイクルの複数工程を自動化しています。[2]
つまり、ソフトウェアファクトリーの本質は「書く人をAIに置き換えること」ではありません。工程ごとに専門化したエージェントと検査機構を配置し、成果物が次の工程へ進める状態かを連続的に判断することにあります。
AIで実装が速くなるほど、検品がボトルネックになる
人間のエンジニアが数日かけていた実装をAIが数十分で終えられるようになると、レビュー待ちのプルリクエストは急速に積み上がります。ここで検品工程が従来のままなら、開発全体は速くなりません。むしろ、人が確認しきれない変更が増え、見落としや手戻りのリスクが高まります。
製造業に置き換えると、組立ラインだけを高速化して、検査員と検査設備を増やしていない状態です。完成品は次々に流れてきますが、出荷判定が追いつきません。
だからこそ、AI駆動開発では「どう書かせるか」と同じか、それ以上に、次の問いを先に設計する必要があります。
- 何を合格条件とするか
- どの検査は決定論的なツールで行うか
- どの検査はAIの判断を使うか
- 一つの検査結果を、別の検査でどう再確認するか
- 失敗した場合、どの工程まで戻して修正するか
- どの例外を人へエスカレーションするか
- すべての検査を通過したことを、どの証跡で確認するか
これらを実行する外側の仕組みが、エージェントのハーネスです。ハーネスは、モデル、ツール、コンテキスト、権限、状態、停止条件、ログ、再試行を束ね、開発から検品までの流れを制御します。
Uberが示す「生成」と「検証」を分ける設計
UberのAIコードレビュープラットフォーム「uReview」は、検品工程を分解して設計した分かりやすい例です。「uReview: Scalable, Trustworthy GenAI for Code Review at Uber」によると、uReviewはレビューコメントを一度生成して終わるのではなく、コメント生成、品質評価、類似コメントの統合、カテゴリ分類と抑制という多段階の処理を行います。[3]
これは、AIの出力をそのまま出荷判定に使わない設計です。生成担当とは別の評価工程を置き、信頼度の低い指摘や、過去に価値が低いと評価されたカテゴリを落とします。人が読む前に、AIの出力自体を検品しているわけです。
Uberは、実際の不具合が分かっているコミットを用いてprecision、recall、F1を測定し、モデル構成を比較しています。また、レビューコメントが最終コミットで修正されたか、開発者が「Useful / Not Useful」のどちらを選んだかも継続的に収集しています。[3]
ここから得られる教訓は明確です。AIレビューの品質は「高性能なモデルを選んだか」だけでは決まりません。
- 実際の仕事からベンチマークを作る
- 生成と評価を別工程にする
- 誤検知と低価値な指摘を抑制する
- 現場の反応を次の評価データへ戻す
- 品質・コスト・速度を同時に計測する
Uberのソフトウェアファクトリー記事も、モデル選定について「Build a benchmark out of the agent’s real work.(エージェントの実際の仕事からベンチマークを作る)」ことを最初の手順に置いています。[2] 汎用ベンチマークの順位ではなく、自社の成果物を正しく検品できるかを基準にするということです。
検品はコードだけでは終わらない
ソフトウェアの品質をコードだけで定義すると、検品ラインには大きな抜けが生まれます。コードが正しくても、画面が仕様と違うことがあります。画面がデザインどおりでも、操作が分かりにくいことがあります。操作できても、実際の業務を完了できないことがあります。
以前の記事、「強いAI駆動開発は「ループの強さ」から生まれる」でも解説しましたが、ソフトウェアファクトリーには、多段的な検品プロセスがあり、私は理想形を以下のように整理します。
1. コードの検品
lint、型チェック、ユニットテスト、依存関係、認証・認可、入力値検証、秘密情報の扱いなどを確認します。構文や定型ルールは、AIよりも決定論的なツールのほうが安く、速く、再現性があります。
一方、設計意図との不一致、意味的な不具合、プロジェクト固有の規約などは、コードと周辺コンテキストを読めるAIレビューが有効です。重要なのは、AIにすべてを任せるのではなく、機械的な検査と意味的な検査を役割分担することです。
2. 振る舞いの検品
アプリケーションを実際に起動し、ブラウザや端末を操作してE2Eテストを行います。「入力できる」「保存できる」「画面遷移する」だけでなく、データが期待した状態になっているか、コンソールエラーが出ていないか、外部サービスとの連携が完了したかまで確認します。
Uberのソフトウェアファクトリーでは、視覚検証を含むE2Eのプルリクエスト作成もマネージドエージェントの仕事として挙げられています。[2] 実装エージェントが「できた」と自己申告するのではなく、実行結果を別の信号で確かめることが重要です。
3. デザインの検品
完成画面のスクリーンショットを取得し、デザインシステムや承認済みの画面と比較します。余白、文字サイズ、色、コンポーネント、レスポンシブ表示、崩れ、アクセシビリティを確認します。
Uberのデザインシステムチームは「How Uber Built an Agentic System to Automate Design Specs in Minutes」で、Figmaの実データをAIエージェントが読み、構造、API、バリアント、デザイントークン、余白、スクリーンリーダー向け仕様を含むコンポーネント仕様を生成する仕組みを紹介しています。[4]
ここで重要なのは、画像をそれらしく見るだけでなく、デザインの判断基準を構造化している点です。AIが読むべきデータと、守るべきスキーマ、参照すべきアクセシビリティ仕様をスキルとして持たせています。これにより、デザインレビューを属人的な「違和感チェック」から、繰り返し可能な工程へ近づけています。
4. UXの検品
UXレビューでは、仕様どおりに動くかではなく、ユーザーが目的を達成できるかを確認します。
- ユーザーが達成したい業務(ユーザーストーリー)が達成できるか
- 初めて触る人が、次に何をすべきか理解できるか
- 入力項目の意味や必須条件が分かるか
- エラーから自力で復帰できるか
- 空の状態で、始め方が示されているか
- 主要な仕事を不必要に多い手順で行わせていないか
- 操作の結果とシステムの状態が利用者に伝わるか
これらは単一の正解へ落としにくい一方、ユーザーストーリー、ペルソナ、ヒューリスティクス、禁止パターン、成功条件を与えることで検査可能になります。たとえば「初回利用者が説明なしで請求書を作成し、下書き保存できる」といったシナリオを定義し、操作ログ、スクリーンショット、所要手順、迷いが生じた箇所を評価します。
5. 出荷の検品
最後に必要なのが、リリースしてよいかを判断するゲートです。すべてのテスト結果、レビュー結果、例外、未解決事項を集約し、リスクに応じて自動出荷、人の承認、差し戻しを選びます。
ここで「テストが通った」という一つの信号だけを見てはいけません。機能、セキュリティ、デザイン、UX、性能、運用準備の各検査が完了し、証跡が残っていることが出荷条件です。ソフトウェアファクトリーの完成度は、コードを作る速さではなく、この出荷判定の確かさに現れます。
良い検品ハーネスを作る6つの原則
以下は、UBERの発信や、弊社のAI駆動開発体制をふまえて策定した良い検品ハーネスをつくる原則です。
原則1:合格条件を、実装前に決める
完成後に「良さそうか」を議論すると、検品は主観に引っ張られます。ユーザーストーリー、受け入れ条件、非機能要件、デザイン基準、UXシナリオを、実装前に定義します。
原則2:一つのAIに、実装と合格判定を兼任させない
自分で書いた成果物を、自分と同じコンテキストで評価すると、前提や見落としも共有されます。実装、コードレビュー、デザインレビュー、UXレビューは、可能な限り別のエージェント、別のプロンプト、別のコンテキストで行います。
原則3:曖昧な感想を、観測可能な信号へ変える
「使いやすい」「きれい」「品質が高い」だけでは、ループを回せません。操作完了率、手順数、エラー復帰の可否、画面差分、アクセシビリティ違反、性能値、誤検知率など、AIと人が共有できる信号へ分解します。
原則4:実際の仕事をベンチマークにする
一般的な評価セットだけでなく、自社で過去に発生した不具合、レビュー指摘、デザイン崩れ、問い合わせ、手戻りを評価データへ変えます。工場に流れる製品が違えば、検査装置の調整も変わります。
原則5:失敗時の戻り先を決める
検査に落ちたとき、単に「失敗」と通知するだけでは人の仕事が増えます。原因を特定し、修正し、必要な検査から再実行するところまでをループに含めます。ただし、権限変更、個人情報、課金、公開、データ削除など高リスクな操作は人へ戻します。
原則6:品質だけでなく、検品コストも測る
すべてを最上位モデルで何度も検査すれば、コストと時間が膨らみます。Uberは、マネージドエージェントを「マージされたPRあたりの費用」「レビューあたりの費用」といった成果単位で計測し、品質信号と併せて管理しています。[2] どの検査へどのモデルを使うか、決定論的なツールへ置き換えられないか、失敗時だけ高性能モデルへ切り替えられないかを継続的に調整します。
人の役割は「全件検査」から「検査工程の設計」へ移る
AIが開発から検品までを担うようになると、人が不要になるわけではありません。人の役割が変わります。
従来は、成果物を一つずつ読み、動かし、問題を見つけることが中心でした。ソフトウェアファクトリーでは、人は目的、制約、品質基準、例外条件を定義し、検査ライン全体を改善します。そして、機械的に判定できないトレードオフや、高リスクな判断に集中します。
これは、以前の記事「強いAI駆動開発は『ループの強さ』から生まれる」で紹介した、ヒューマン・イン・ザ・ループからヒューマン・オン・ザ・ループへの移行ともつながります。人が毎回の実装を承認するのではなく、ループの外側から監督し、例外時に介入する。そのためには、人が離れても品質を観測できる検品ハーネスが必要です。
結びに:AI駆動開発はPolyscapeへ
生成AIによって、コードを書く能力は急速にコモディティ化しています。これから差がつくのは、生成速度そのものではなく、何を良いソフトウェアと定義し、それを繰り返し検証し、安心して出荷できるかです。
ソフトウェアファクトリーは、AIに大量のコードを書かせる仕組みではありません。要件とデザインを入力し、実装、コードレビュー、E2E、デザインレビュー、UXレビュー、修正、出荷判定までを一気通貫で動かす品質システムです。
Polyscapeでは、AI駆動開発におけるSPECDOC、コーディングエージェント、ブラウザ操作、視覚検証、複数観点のレビュー、出荷ゲートを組み合わせ、開発速度を品質へ変換するハーネスの設計・研究・実装に取り組んでいます。AI駆動開発の導入や、既存の開発プロセスをソフトウェアファクトリー型へ移行したい方は、お気軽にご相談ください。
ここまで読んでいただき、ありがとうございました。
参考リンク
[1] 5 Trends That Defined AI Engineering at World’s Fair 2026 | Latent Space
[2] Running a Software Factory Efficiently at Uber Scale | Uber
[3] uReview: Scalable, Trustworthy GenAI for Code Review at Uber | Uber
[4] How Uber Built an Agentic System to Automate Design Specs in Minutes | Uber


